إطار البيانات في pandas
في بايثون مثّلنا مجموعة البيانات المرتَّبة بالقائمة (list) والمسماة بالقاموس (dict). فاستعملنا الكرَّ لإجراء العمليات على عناصر المجموعة، وربما استعملنا الصيغة المختصرة لأنماط معروفة في المعالجة: كالترشيح والتحويل والتلخيص ونحوها.
مكتبة pandas
وقد صاغ المهندسون مكتبة pandas المخصصة لمعالجة البيانات المجدوَلة. وهي من أشهر مكتبات بايثون. وهي مبنيَّة على أساس مكتبة معالجة المتجهات والمصفوفات الرياضية: numpy وقد تكون من أشهر مكتبات بايثون على الإطلاق؛ لأسباب: أحدها كفاءتُها كوْنها مكتوبة بلغة C++ بشكل يتواءم ويتوفَّر كمكتبة لمطوري بايثون.
إطار البيانات (DataFrame)
إطار البيانات (DataFrame) جدول ذو صفوف وأعمدة مسمّاة. يمثّل كل عمود سلسلةً (Series)، وتشترك الأعمدة في فهرس (Index) يسمّي الصفوف.
الإدخال والإخراج
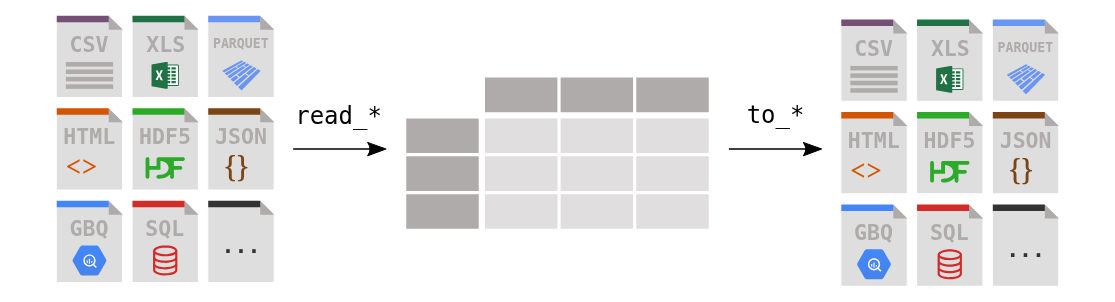
يمكن تحميل البيانات إلى إطار بيانات DataFrame من مصادر متعددة وبصيغ مختلفة، منها:
- قواعد البيانات: العلائقية التي نستعلم عنها بلغة SQL، وغير العلائقية (NoSQL).
- الاستبيانات: مثل Google Forms وSurveyMonkey.
- واجهات برمجة التطبيقات (APIs): بيانات منصات التواصل الاجتماعي وOpenStreetMap والرحلات الجوية وغيرها.
- استخلاص البيانات من صفحات الويب: باستخدام أدوات مثل BeautifulSoup وScrapy وSelenium.
- الملفات: مثل CSV وExcel وTXT وJSON وXML وPDF وغيرها.
نستخدم الاسم المختصر pd لمكتبة pandas، كما سنفعل في جملة الاستيراد في المثال الأول. قد نحتاج إلى أداة لجمع البيانات أو استخراجها أولًا، ثم تحويلها إلى جدول؛ فمثلًا لا تقرأ pandas ملفات PDF مباشرةً. وتوفّر المكتبة دوال لقراءة صيغ ومصادر كثيرة، منها CSV وExcel وSQL وJSON وParquet. تبدأ أسماء دوال القراءة عادةً بـ read_*، مثل pd.read_excel() وpd.read_json() وpd.read_sql()؛ وقد تحتاج بعض الصيغ إلى مكتبات إضافية.
ملفات CSV
لقراءة ملف CSV إلى إطار بيانات، نستخدم الدالة pd.read_csv(). سنتدرّب عليها في هذا الدرس، ثم نحفظ الناتج باستخدام طريقة الحفظ على الجدول الناتج. نرمز إلى إطار البيانات عادةً بالاسم df، فتكون الصيغة df.to_csv(). سنستخدم اسم الجدول الفعلي في كل مثال.
في هذه الدروس سنبدأ عادة بعرض بيانات الدرس، وهي ملفات نصيَّة بصيغة csv حيث البيانات مرتَّبة كنصوص مفصولة بفواصِل. لاحظ -في البيانات التالية- مثلاً في السطر الأوَّل أن كل فاصلة تحدد مكان العمود. ثم في السطور التالية، كل فاصلة تجعل القيمة منتمية للعمود المقابل لها في الأعلى. وبالتالي سميِّت القيم المفصولة بالفاصلة (Comma-separated Values: CSV).
بيانات الدرس
توفّر academy.get_data_url() رابط ملف البيانات في GitHub. افتح اسم الملف لمعاينة بياناته، ثم اقرأ الرابط باستخدام pandas.
أولاً: قراءة البيانات
يحوي الملف abc.csv ثلاثة أعمدة وصفّين من الأعداد. السطر الأول في الملف هو أسماء الأعمدة، والفواصل تفصل بين الخانات. نستخدم pd.read_csv() لتحويل هذا النص إلى جدول.
المخرجات:
- لاحظ أن الأرقام
0و1على الجانب الأيسر ليست عمودًا من الملف؛ بل هي فهرس (Index) لتلك الصفوف الذي أضافته المكتبة. - أما
aوbوcفهي أسماء الأعمدة المقروءة من السطر الأول.
ثانيًا: فحص البيانات
يسجّل الملف wpm.csv عمودين:
wpm: سرعة الكتابة بالكلمات في الدقيقة.light: ما إذا كانت الإضاءة موجودة أثناء القياس.
نقرأ القياسات في إطار بيانات باسم wpm، ثم نعرض أول خمسة صفوف باستخدام df.head(). يمثّل كل صف قياسًا واحدًا:
تعرض المعاينة خمسة قياسات. يبيّن عمود wpm سرعة كل قياس، وتدل False في عمود light على غياب الإضاءة.
يتم استنتاج الأنواع عند القراءة؛ ويمكن معرفتها بالخاصية df.dtypes:
- نوع عمود
wpmهوint64، أي أعداد صحيحة. - نوع عمود
lightهوbool، أي قيم منطقية.
هذا نوع التخزين في البرنامج؛ أما كون المتغيّر كميًا أو نوعيًا فيتعلق بمعنى قيمه.
ثالثًا: المعالجة
نعود إلى الجدول العددي الأول، لنبيِّن أي نوع من أنواع المعالجة؛ ولنفرض أننا نريد ضرب جميع القيم بعشرة:
فالجدير بالملاحظة هو أنَّ البيانات في data لم تتغيَّر. وإنما scaled هي نسخة منها تمَّ تطبيق عملية الضرب عليها.
رابعًا: حفظ نتائج المعالجة
وجود الجدول في متغيّر لا يغيّر الملف الأصلي. نكتب الناتج إلى ملف آخر باستخدام df.to_csv():
خلاصة
يمرّ العمل على البيانات بخمس مراحل مترابطة:
- الإدخال: نحدّد مصدر البيانات، مثل ملف CSV.
- التحميل: نقرأ البيانات إلى ذاكرة البرنامج لتصبح جاهزة للعمل عليها.
- المعالجة: نجري العمليات المطلوبة، مثل ضرب القيم أو ترشيح الصفوف أو تلخيصها.
- التنسيق: نهيّئ النتائج بالصورة المناسبة للاستخدام، مثل اختيار الأعمدة التي نريد حفظها وصيغة الملف.
- الإخراج: نعرض النتائج أو نحفظها في ملف أو نرسلها إلى وجهتها.
في pandas، إطار البيانات (DataFrame) هو الكائن الذي نجري عليه العمليات الحسابية ومعالجة البيانات المجدوَلة. توفّر المكتبة دوال القراءة، مثل pd.read_csv()، لتحميل البيانات إلى هذا الكائن؛ ويوفّر إطار البيانات طرق الكتابة، مثل df.to_csv()، لإخراج بياناته بالصيغ المختلفة. وهكذا يكون إطار البيانات محور العمل بين قراءة البيانات وكتابة النتائج.